AI Visibility Lab · Articole
AI ca oglindă și amplificator: ce arată raportul Anthropic despre intenție, context și folosirea Claude
Raportul Anthropic din septembrie 2026 arată cum actori foarte diferiți au folosit Claude pentru operațiuni cibernetice, supraveghere, influență, fraude și alte forme de abuz. Analiza separă faptele documentate de interpretarea editorială despre intenție, context și amplificare.
Alex Matescu · Fondator și coordonator AI Visibility Lab
Publicat: · Ultima verificare factuală:
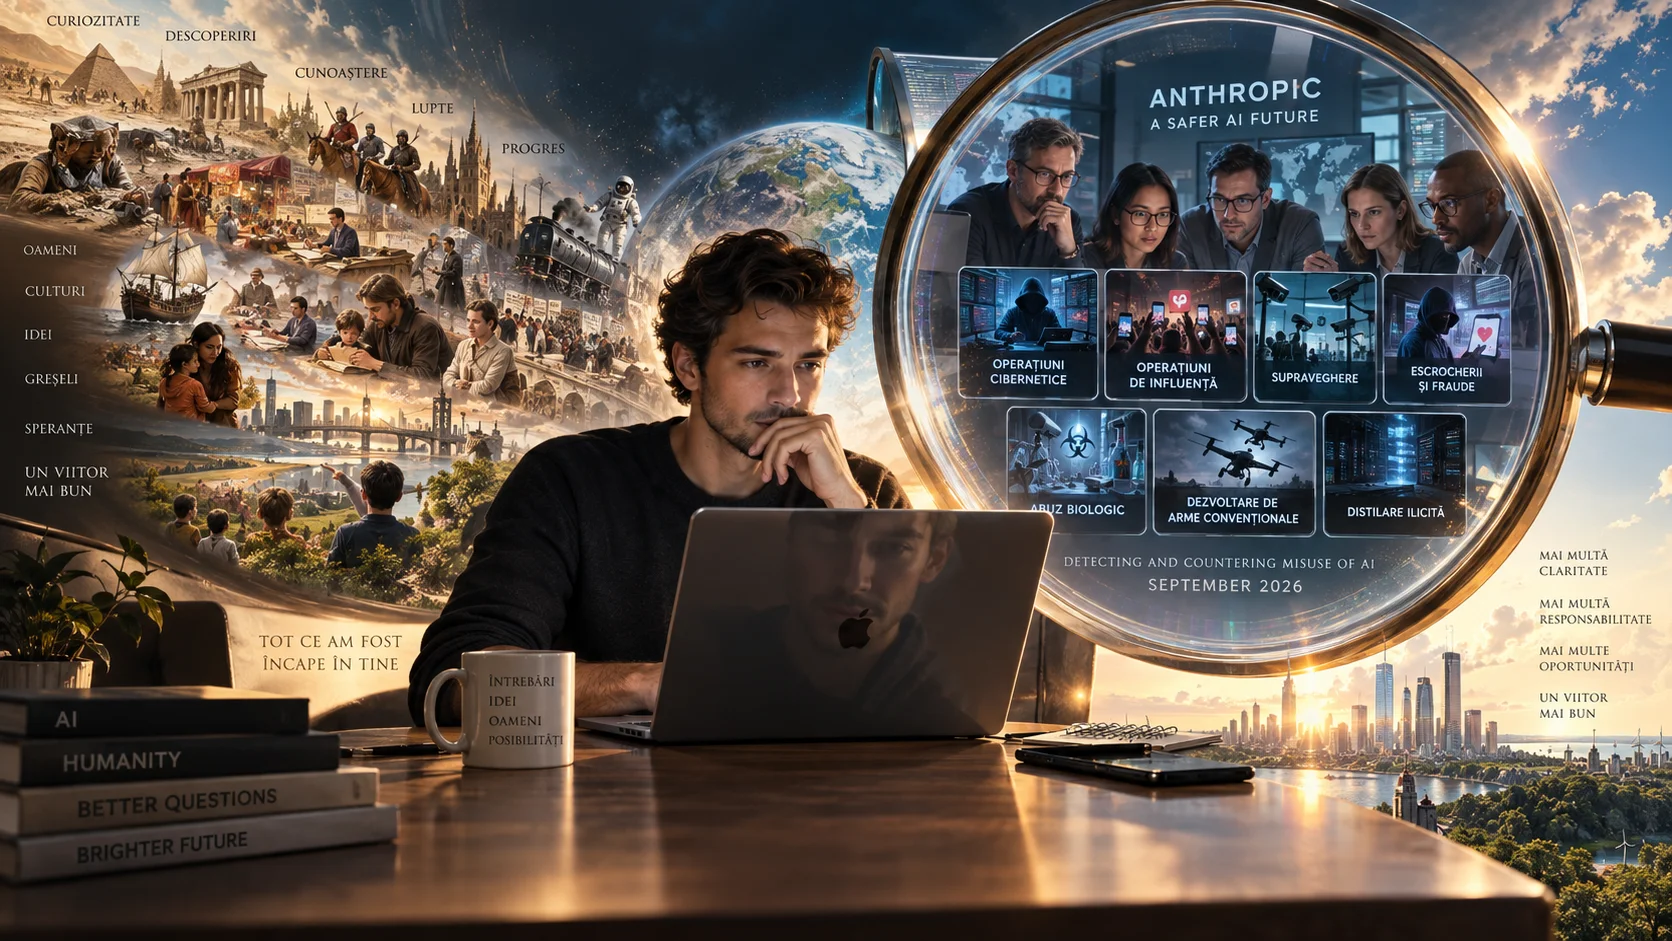
Raportul Anthropic din septembrie 2026 nu demonstrează că AI-ul este literalmente o „oglindă” a utilizatorului. Arată însă ceva mai precis și mai util: aceleași capabilități generale pot fi integrate în scopuri foarte diferite, iar modelele pot reduce costul, timpul și volumul de muncă necesare pentru executarea unei intenții deja stabilite de om. În utilizarea legitimă, documentația Anthropic și OpenAI susține o a doua idee: instrucțiunile clare, contextul relevant și rafinarea iterativă pot îmbunătăți rezultatele, fără să le garanteze.
Pe 10 septembrie 2026, Anthropic a publicat raportul „Detecting and countering misuse of AI: September 2026”, bazat pe activități pe care echipa sa de Threat Intelligence spune că le-a identificat și întrerupt între decembrie 2025 și august 2026.1 Raportul acoperă șapte arii de risc: operațiuni cibernetice, operațiuni de influență, supraveghere, escrocherii și fraude, abuz biologic, dezvoltarea de arme convenționale și distilare ilicită. Anthropic precizează că exemplele publicate nu reprezintă utilizarea tipică a Claude, ci unele dintre cele mai notabile și noi cazuri de abuz observate de companie.1
Această limită contează. Raportul nu este o radiografie a tuturor utilizatorilor AI și nici o demonstrație experimentală despre natura umană. Este o colecție de cazuri selectate de un furnizor pe baza vizibilității pe care o are asupra propriei platforme.
Dar tocmai în aceste limite apare o întrebare interesantă: ce se întâmplă când aceeași clasă de instrumente devine disponibilă unor oameni cu intenții, standarde și niveluri de perseverență foarte diferite?
Răspunsul meu este o metaforă, nu o concluzie a raportului: AI-ul poate funcționa ca oglindă și amplificator. Oglindă, pentru că instrucțiunile și contextul utilizatorului influențează direcția rezultatului. Amplificator, pentru că anumite sarcini pot fi executate mai repede, la scară mai mare sau cu mai puțină muncă umană. Metafora are însă limite importante: modelul nu reflectă pasiv orice cerere, nu este omnipotent și nu transformă automat intenția în rezultat.
Răspunsul scurt: AI-ul amplifică intenția utilizatorului?
În anumite condiții, da — dar „amplifică” este o interpretare, nu un mecanism universal demonstrat. Raportul Anthropic documentează cazuri în care Claude a redus necesarul de muncă, a accelerat dezvoltarea de instrumente sau a permis unor operatori să gestioneze activități care ar fi cerut anterior mai multe resurse. Anthropic descrie explicit această schimbare prin viteză, scară și profunzime și afirmă, în contextul operațiunilor cibernetice analizate, că diferența dintre actori bine finanțați și actori mai mici nu mai poate fi dedusă la fel de ușor din sofisticarea tehnică.1
Asta nu înseamnă că modelul adaugă pur și simplu putere oricărei intenții. Rezultatul depinde de capabilitățile modelului, calitatea informației de intrare, instrumentele disponibile, verificarea umană, restricțiile produsului și măsurile de siguranță. În mai multe cazuri din raport, Claude a refuzat sau a limitat cereri, iar Anthropic a detectat și a blocat conturi implicate în abuz.1
Partea I. Ce vrei: AI-ul ca oglindă imperfectă
Cazul Lakana 360: intenția exista înaintea instrumentului
Unul dintre cele mai clare exemple din raport este GTG-50027. Anthropic spune că un singur abonat Claude, evaluat de companie drept probabil consultant independent din Bamako care lucra cu serviciul de informații al statului Mali, ANSE, a folosit Claude drept principală forță de inginerie pentru un sistem numit „Lakana 360”. Platforma era concepută pentru supraveghere internă la scară națională și viza aproximativ 25 de milioane de cartele SIM de la cei trei operatori mobili naționali.1
Raportul afirmă și că operatorul a proiectat sistemul pentru a ocoli restricții legale din Mali care cer un ordin judecătoresc pentru divulgarea anumitor înregistrări. În componenta care genera dosare de intelligence pentru numere de telefon, cerința de mandat a fost eliminată la solicitarea operatorului.1
Aici metafora oglinzii este utilă: Claude nu a inventat clientul, obiectivul instituțional sau decizia de a elimina controlul juridic. Acestea aparțineau actorului. Modelul a fost folosit pentru proiectare și inginerie.
Dar metafora devine falsă dacă o ducem prea departe.
De ce AI-ul nu este o oglindă perfectă
O oglindă reflectă orice fără să intervină. Un model comercial nu funcționează așa. Are antrenament, politici, instrucțiuni de sistem, filtre, monitorizare și alte mecanisme care îi pot modifica sau opri comportamentul.
Raportul oferă exemple concrete. În cazul GTG-84005, o platformă comercială de manipulare electorală care viza Malaysia, Anthropic spune că Claude a refuzat sau a refuzat parțial anumite solicitări, inclusiv după ce a identificat un dosar fabricat drept material pentru defăimare politică. Actorul a încercat apoi să reformuleze cererile pentru a continua construirea capabilității.1
Într-o operațiune de influență din Republica Centrafricană, raportul descrie de asemenea situații în care modelul a opus rezistență unor solicitări mai agresive, iar operatorul a încercat să le reformuleze.1
Prin urmare, formularea mai exactă este aceasta:
AI-ul poate reflecta și amplifica o parte din intenția utilizatorului, dar rezultatul este mediat de capabilitățile modelului, context, instrumente, politici și mecanisme de siguranță.
Nu este la fel de memorabil ca „AI-ul este o oglindă”. Este însă mai aproape de ceea ce dovezile permit să spunem.
Amplificatorul: ce s-a schimbat în economia execuției
Una dintre concluziile cele mai puternice ale raportului Anthropic privește economia operațiunilor cibernetice. Compania notează că tehnicile de bază observate — credențiale furate, sisteme neactualizate, servicii expuse, SQL injection sau phishing — nu sunt complet noi. Schimbarea este în costul și viteza execuției.1
Anthropic descrie munca de recunoaștere, exploatare, dezvoltare de instrumente și procesare de date ca fiind delegată tot mai mult modelelor AI, uneori în fluxuri paralele. În cazurile analizate, compania raportează breșe finalizate în două-trei ore și zeci de victime gestionate în paralel de operatori individuali.1
În cazul GTG-10007, Anthropic descrie operatori vorbitori de chineză care au folosit fluxuri autonome și memorie persistentă de campanie. Listele de ținte, credențialele colectate, starea operațiunilor și instrucțiunile permanente erau păstrate între sesiuni, astfel încât activitatea să poată fi reluată cu contextul acumulat. Un flux continuu de cercetare asupra echipamentelor de rețea a produs, potrivit raportului, peste o duzină de posibile vulnerabilități zero-day într-o lună.1
Aici „amplificator” descrie mai bine fenomenul decât „oglindă”. Nu pentru că AI-ul ar avea un buton universal de multiplicare, ci pentru că automatizarea, paralelizarea și păstrarea contextului pot reduce costul marginal al unor activități.
Aceeași proprietate este valoroasă și în utilizări legitime: un om poate folosi un model pentru a structura informații, a genera variante, a analiza documente, a scrie cod sau a itera asupra unei probleme. Raportul de threat intelligence nu măsoară aceste beneficii și nu trebuie folosit ca dovadă pentru ele. Pentru partea legitimă a argumentului, sursele potrivite sunt documentațiile despre prompting și context, nu cazurile de abuz.
Partea a II-a. Cât ceri: de ce contextul și iterația contează
Nu există dovadă că „majoritatea oamenilor se opresc la primul răspuns”
O formulare tentantă ar fi că oamenii obțin rezultate mediocre pentru că se mulțumesc cu primul răspuns. Nu am găsit în sursele folosite aici date care să susțină o asemenea generalizare.
Ce poate fi susținut este mai restrâns: atât Anthropic, cât și OpenAI recomandă instrucțiuni clare și specifice, context suficient și rafinare iterativă pentru a obține rezultate mai utile.23
Anthropic recomandă explicit să spui clar ce rezultat dorești, să oferi context și să folosești exemple atunci când acestea ajută. OpenAI recomandă, la rândul său, prompturi clare și specifice și rafinarea cererii după evaluarea răspunsului.23
Așadar, diferența dintre un prompt vag și unul bine contextualizat nu este o regulă magică de tipul „mai multe cuvinte = răspuns mai bun”. Este o problemă de semnal relevant.
Cățelul pe care nu îl dresezi — și limita metaforei
Îmi place o comparație: iei un pui de câine și vrei să-l dresezi. Rezultatul depinde mult de consecvența cu care lucrezi cu el. Dacă renunți repede, nu ai testat limita animalului; ai testat limita procesului tău.
Cu AI-ul, comparația funcționează doar până la un punct.
Într-o conversație, feedbackul, exemplele și corecțiile pot schimba răspunsurile ulterioare. Dar nu este corect să spunem în mod general că modelul „învață permanent” din fiecare corecție. Continuitatea depinde de produs și de configurație: poate exista context în conversație, memorie de produs, fișiere persistente sau memorie construită într-un agent. Anthropic documentează explicit asemenea mecanisme de context persistent în sisteme agentice.4
Prin urmare, nu „dresezi” pur și simplu modelul. Construiești contextul în care modelul lucrează și, în același timp, îți rafinezi propria capacitate de a formula problema.
Un exemplu simplu: problema bateriei
Întrebarea:
„De ce nu mai funcționează bine bateria mașinii?”
lasă deschise prea multe variabile.
O cerere de forma:
„Care sunt trei ipoteze plauzibile pentru un VW Golf V 2.0 TDI din 2008, dacă bateria este nouă de patru luni, dar se descarcă peste noapte și dimineața mașina pornește doar cu cabluri? Spune-mi ce informații lipsesc înainte de a trage o concluzie.”
oferă modelului mai mult context și îi cere să distingă ipoteza de diagnostic.
A doua formulare nu garantează un răspuns corect. Poți oferi un an greșit, o motorizare greșită sau un simptom interpretat greșit și să obții un răspuns foarte specific construit pe premise false. Specificitatea crește utilitatea doar dacă informația de intrare este suficient de corectă și dacă rezultatul este verificat acolo unde miza o cere.
Context engineering: nu lungimea promptului, ci informația relevantă
Pe măsură ce sistemele au devenit mai capabile și mai agentice, discuția s-a mutat parțial de la „prompt engineering” la „context engineering”. Anthropic definește problema ca alegerea și organizarea contextului care crește probabilitatea comportamentului dorit al modelului.4
Asta corectează o altă exagerare frecventă: un prompt lung nu este automat un prompt bun. Contextul inutil poate consuma atenție fără să ajute. Un prompt scurt poate fi excelent dacă sarcina este clară. Un prompt lung poate fi prost dacă amestecă obiective, excepții și informații irelevante.
Întrebarea utilă nu este „cât de mult îi cer?”, ci:
I-am dat modelului informația, constrângerile, criteriile și instrumentele de care are nevoie pentru sarcina aceasta?
Alegerea instrumentului: „AI-ul de familie” nu este specialist universal
Mai există o formă de disciplină care nu ține de prompt: alegerea instrumentului.
Este comod să folosim același asistent pentru orice. Dar modelele, modurile de lucru și instrumentele diferă. Unele sarcini cer acces la web și surse actuale. Altele cer execuție de cod, analiză de fișiere, baze de date sau un instrument specializat. Iar în domenii cu miză ridicată, AI-ul poate fi un ajutor pentru înțelegere, nu un înlocuitor automat pentru expertiza profesională.
Nu este corect să presupunem că un asistent AI nu va recomanda niciodată un alt instrument sau un specialist. Poate face asta. Problema este că utilizatorul nu trebuie să externalizeze complet decizia privind adecvarea instrumentului către instrumentul însuși.
A ști când să schimbi modelul, să activezi căutarea, să verifici sursa sau să mergi la un specialist face parte din competența de utilizare a AI.
Ce arată concret raportul Anthropic din septembrie 2026
Raportul conține suficiente cazuri încât detalierea fiecăruia ar transforma această analiză într-un rezumat al documentului original. Pentru teza articolului sunt mai importante tiparele decât inventarul complet.
| Caz / zonă | Ce documentează Anthropic | Ce putem spune prudent |
|---|---|---|
| GTG-50027 — Mali | Un singur abonat a folosit Claude ca principală forță de inginerie pentru Lakana 360, o platformă de supraveghere la scară națională | AI poate reduce necesarul de muncă inginerească pentru un actor cu obiectiv și client deja definite |
| GTG-10007 — operațiuni cibernetice | Fluxuri paralele, memorie persistentă de campanie și cercetare automatizată de vulnerabilități | Contextul persistent și automatizarea pot crește continuitatea, viteza și scala |
| GTG-54002 — influence-as-a-service | Aproximativ 70 de site-uri fabricate, 70 de conturi X asociate, peste 250 de conturi de comentarii și cel puțin 8.913 articole | AI poate susține producție și rescriere de conținut la scară, fără ca asta să garanteze audiență reală |
| GTG-84005 — Malaysia | Aproximativ 1.000 de conturi false, un site de știri fabricat și dosare false; Claude a refuzat unele cereri | Intenția operatorului nu se transformă automat în obediență a modelului; există fricțiuni și refuzuri |
| GTG-50029 — hacktivism | O singură persoană a construit instrumente și o platformă de doxxing cu asistență AI | Unele capabilități care cereau mai multe resurse pot deveni accesibile unui operator individual |
| Operațiuni de influență | Nouă cazuri, cu multe operațiuni oprite înainte de a obține audiență autentică | Capacitatea de producție nu este echivalentă cu impactul |
Sursa primară pentru toate aceste descrieri este raportul Anthropic.1 Cifrele și atribuirea actorilor trebuie citite ca rezultate ale investigației companiei, nu ca statistici independente despre întregul ecosistem AI.
Ce nu demonstrează raportul
Raportul nu demonstrează că AI-ul face oamenii mai buni sau mai răi. Nu demonstrează că orice utilizator poate obține „munca unei echipe de zece experți”. Nu demonstrează că un prompt mai lung produce automat un rezultat mai bun. Nu demonstrează că utilizatorii perseverenți obțin întotdeauna rezultate remarcabile și nici că utilizatorii cu așteptări mici obțin inevitabil rezultate mediocre.
De asemenea, raportul nu trebuie citit ca o evaluare independentă a eficacității măsurilor Anthropic. Compania este simultan furnizorul produsului, investigatorul activității de pe propria platformă și autorul raportului. Asta îi oferă acces privilegiat la date, dar înseamnă și că unele afirmații nu pot fi verificate integral din exterior.
Această separare dintre fapt documentat și interpretare este esențială.
Ce rămâne din metafora oglinzii și amplificatorului
După toate corecțiile, ideea centrală rămâne — doar că devine mai precisă.
Oglinda: modelul răspunde la obiectivele, contextul, exemplele și constrângerile pe care le primește, dar nu le reflectă mecanic.
Amplificatorul: automatizarea, viteza, paralelizarea și accesul la capabilități pot mări ceea ce un utilizator poate executa, dar nu în mod nelimitat și nu fără dependență de instrumente, verificare și safeguards.
Omul: intenția, selecția problemei, criteriile de succes și responsabilitatea pentru folosirea rezultatului rămân, în multe situații, în afara modelului.
Aici este partea care mă interesează cel mai mult. Nu ideea că AI-ul ne va transforma inevitabil, ci faptul că ne obligă să fim mai expliciți cu ceea ce vrem.
Trei întrebări înaintea unei conversații importante cu AI
1. Ce încerc de fapt să obțin?
Nu „ce prompt să scriu?”, ci care este rezultatul real pe care îl urmăresc și după ce criterii îl voi considera bun.
2. Ce context și ce dovezi îi lipsesc modelului?
Ce știe din conversație? Ce trebuie să-i ofer? Are nevoie de surse actuale, documente, date, instrumente sau exemple? Ce premise trebuie verificate?
3. Ce parte din rezultat rămâne responsabilitatea mea?
Unde trebuie să verific? Ce decizie nu ar trebui delegată? Ce consecințe apar dacă răspunsul este greșit?
Aceste trei întrebări sunt mai puțin spectaculoase decât promisiunea unei „echipe de experți într-o fereastră de chat”. Sunt însă mai utile.
Concluzie
Raportul Anthropic din septembrie 2026 documentează ceva important: în unele operațiuni investigate, AI-ul a redus barierele de muncă, timp și expertiză necesare pentru activități pe care oamenii intenționau deja să le execute.1 În același timp, raportul documentează refuzuri ale modelului, detectarea abuzului și limite ale intervenției furnizorului — inclusiv cazul Lakana 360, unde blocarea contului a oprit accesul actorului la Claude, dar nu și platforma deja instalată local.1
De aici, afirmația „AI-ul nu te schimbă, te amplifică” poate funcționa ca teză editorială, dacă nu o confundăm cu o lege demonstrată.
Mai exact: AI-ul poate amplifica o intenție, o metodă de lucru sau o capacitate de execuție. Cât de mult o face depinde de model, context, instrumente, limite și verificare.
Iar întrebarea importantă rămâne una omenească:
Ce alegi să amplifici?
Întrebări frecvente
Raportul Anthropic demonstrează că AI-ul amplifică personalitatea utilizatorului?
Nu. Raportul documentează cazuri de abuz și efecte asupra vitezei, scalei și capabilității operaționale. „Oglinda” și „amplificatorul” sunt metafore editoriale folosite pentru interpretarea acestor observații, nu concluzii științifice formulate de Anthropic.
Prompturile mai detaliate produc întotdeauna răspunsuri mai bune?
Nu. Anthropic și OpenAI recomandă claritate, specificitate, context relevant și iterație, dar asta nu înseamnă că lungimea promptului este un factor universal de calitate. Un context scurt și relevant poate fi mai bun decât unul lung și zgomotos.234
Învață modelul permanent din corecțiile mele?
Nu trebuie presupus acest lucru. Continuitatea depinde de produs și configurație. Un sistem poate folosi contextul conversației, memorie de produs sau fișiere persistente, iar agenții pot fi proiectați să păstreze stare între sesiuni. Aceste mecanisme sunt diferite de afirmația simplificată că modelul de bază „se antrenează” permanent din fiecare corecție a utilizatorului.4
Dacă Anthropic blochează un cont, dispare și sistemul construit cu ajutorul Claude?
Nu neapărat. În cazul Lakana 360, Anthropic afirmă că platforma fusese instalată local și folosea modele locale; blocarea contului a întrerupt activitatea de proiectare și software desfășurată prin Claude, nu și produsul deja implementat.1
Surse și metodologie
Acest articol pornește de la raportul primar Anthropic și verifică separat afirmațiile despre prompting și context prin documentația oficială Anthropic și OpenAI. Cazurile GTG, cifrele și atribuirea actorilor sunt prezentate ca afirmații ale investigației Anthropic. Metaforele „oglindă” și „amplificator”, precum și concluziile despre responsabilitatea utilizatorului, sunt interpretări editoriale ale autorului, nu concluzii atribuite furnizorilor.
- Anthropic — „Detecting and countering misuse of AI: September 2026”, 10 septembrie 2026. Sursa primară pentru toate cazurile GTG, cifrele și citatele din raport, verificate direct în raportul complet: anthropic.com/…/threat-intelligence-report-september-2026
- Anthropic — „Prompting best practices”, Claude Platform Docs. Recomandă claritate și instrucțiuni directe, context suplimentar și folosirea exemplelor pentru a îmbunătăți rezultatele: docs.anthropic.com/…/prompt-templates-and-variables
- OpenAI — „Prompt engineering best practices for ChatGPT”. Recomandă prompturi clare și specifice, cu rafinarea cererii după evaluarea răspunsului primit: help.openai.com/…/prompt-engineering-best-practices-for-chatgpt
- Anthropic — „Effective context engineering for AI agents”. Definește context engineering ca selecția și organizarea contextului pentru a maximiza probabilitatea comportamentului dorit al modelului și documentează mecanisme de context persistent (memory tool, structured note-taking) în sisteme agentice: anthropic.com/engineering/effective-context-engineering-for-ai-agents
Notă de volatilitate
Documentația produselor AI, capabilitățile modelelor și mecanismele de memorie, context și siguranță se pot modifica. Afirmațiile despre produsele curente au fost verificate la 14 septembrie 2026.
Articol publicat de AI Visibility Lab, proiect independent de cercetare aplicată și documentare în AI Visibility, GEO și AEO, fondat și coordonat de Alex Matescu. Ultima verificare factuală și a surselor: 14 septembrie 2026.