AI Visibility Lab · Articole
De unde își iau informațiile sistemele AI? Ce citează ChatGPT, Gemini, Perplexity, Claude și Copilot — și ce arată datele din România
Analiză AI Visibility Lab despre antrenare, căutare și citare în sistemele AI: studii internaționale 2025–2026, statistici despre România, limite metodologice și implicații pentru vizibilitatea companiilor.
Alex Matescu · Fondator și coordonator AI Visibility Lab
Publicat: · Ultima verificare factuală:
Răspunsul scurt: sistemele AI nu funcționează toate pe baza acelorași surse și nu afișează aceleași citări. Unele informații sunt reflectate în parametrii modelelor în urma antrenării; altele sunt recuperate la momentul răspunsului din web, fișiere, baze de date sau instrumente conectate. Nici sursa recuperată, nici cea citată și nici brandul recomandat nu sunt sinonime. Studiile din 2025–2026 măsoară diferențe considerabile între platforme, iar cercetările realizate în România confirmă relevanța subiectului. Dar ele descriu intervale, configurații și eșantioane, nu reguli permanente sau garanții pentru următoarea interogare.
De ce avem nevoie de această comparație?
Un utilizator întreabă ChatGPT care sunt cele mai potrivite servicii pentru o anumită nevoie. Altul adresează aceeași întrebare lui Gemini. Un al treilea consultă Perplexity, iar un antreprenor folosește Microsoft Copilot. Întrebarea este aproape identică. Răspunsurile, însă, pot conține branduri diferite, explicații diferite și liste de surse care nu se suprapun.
Pentru utilizator, aceasta poate părea doar o diferență de stil: un produs afișează trei linkuri, altul zece, altul niciunul. Pentru o companie, diferența poate însemna apariția sau absența într-un moment în care un potențial client caută o soluție.
O asemenea observație ne invită la o întrebare mai dificilă decât „care AI citează mai mult?”: din ce informație este construit răspunsul, ce parte din acel proces putem observa și ce putem face pentru ca informațiile despre o entitate să fie descoperite, înțelese și verificate?
Articolul de față pune împreună documentația oficială a furnizorilor, cercetări comparative internaționale și date dedicate României. Nu tratează platformele drept sisteme cu preferințe permanente și nici statisticile drept promisiuni comerciale.
Patru fenomene pe care nu trebuie să le confundăm
| Concept | Ce înseamnă | Ce nu demonstrează, luat separat |
|---|---|---|
| Antrenare (training) | Modelul își ajustează parametrii pornind de la date și obiective de învățare. | Că un anumit website va fi căutat sau citat într-un răspuns viitor. |
| Recuperare (retrieval) | Sistemul găsește informații suplimentare prin căutare, indexuri, documente, API-uri sau conectori. | Că fiecare rezultat recuperat este folosit ori afișat. |
| Citare (citation) | Produsul afișează un link sau o referință asociată răspunsului. | Că acea sursă explică integral toate afirmațiile sau că brandul este recomandat. |
| Mențiune / recomandare | O entitate apare în text sau este prezentată ca opțiune potrivită. | Că website-ul propriu a fost citat ori că recomandarea conduce la o tranzacție. |
Sursa de antrenare ≠ sursa recuperată ≠ sursa citată ≠ brandul recomandat. Aceasta este distincția de la care pornește întreaga analiză.
1. Ce înseamnă, de fapt, antrenarea unui AI?
Când spunem că un model a fost antrenat, nu afirmăm că a fost conectat permanent la toate paginile de pe internet. În etapa de pre-antrenare, modelul învață regularități, structuri și relații din cantități mari de date, modificându-și parametrii. Etapele ulterioare de post-antrenare urmăresc, prin proceduri variate, îmbunătățirea utilității, comportamentului, fiabilității și siguranței.
OpenAI descrie trei categorii principale de informații folosite la dezvoltarea modelelor sale: informații publice de pe internet, informații accesate prin parteneriate și materiale furnizate sau generate de utilizatori, cercetători și antrenori. Documentația menționează și folosirea datelor sintetice în unele procese. Acesta este un exemplu documentat, nu o afirmație că toți furnizorii utilizează aceeași compoziție a datelor. 1
Imaginează-ți un om care studiază ani la rând pentru a deveni specialist. Poate explica un concept fără să deschidă manualul în care l-a întâlnit. Când i se cere un detaliu nou, poate consulta documentație actualizată. Modelul AI nu învață și nu raționează identic cu omul, iar analogia are limite, dar ea arată diferența dintre ce a fost învățat și ce este consultat la momentul răspunsului.
Există și o nuanță importantă: modelele pot reproduce uneori secvențe memorate ori pot genera afirmații incorecte. Nu trebuie să descriem antrenarea nici ca pe o arhivare literală a fiecărei pagini, nici ca pe o garanție că modelul nu poate reține vreodată fragmente din date. Din exterior, compoziția exactă a datelor de antrenare și contribuția fiecărei surse la un răspuns concret nu sunt, de regulă, observabile integral.
Prin urmare, întrebarea „A fost site-ul meu folosit la antrenarea AI?” este diferită de întrebarea „De ce apare sau nu apare site-ul meu în citările de astăzi?”.
2. Cum ajunge informația actuală într-un răspuns?
Un produs AI poate răspunde pe baza parametrilor modelului sau poate folosi instrumente pentru recuperarea informațiilor. Într-un sistem de tip Retrieval-Augmented Generation (RAG), documentele relevante sunt recuperate și introduse în contextul pe baza căruia este generat răspunsul. Alte arhitecturi pot utiliza căutări web succesive, interogări în baze de date, conectori ori agenți software.
Nu există obligația ca toate aceste mecanisme să fie folosite la fiecare întrebare. Diferențele de produs, versiune, licență, localizare și configurație pot schimba răspunsul.
Traseul simplificat al unei informații
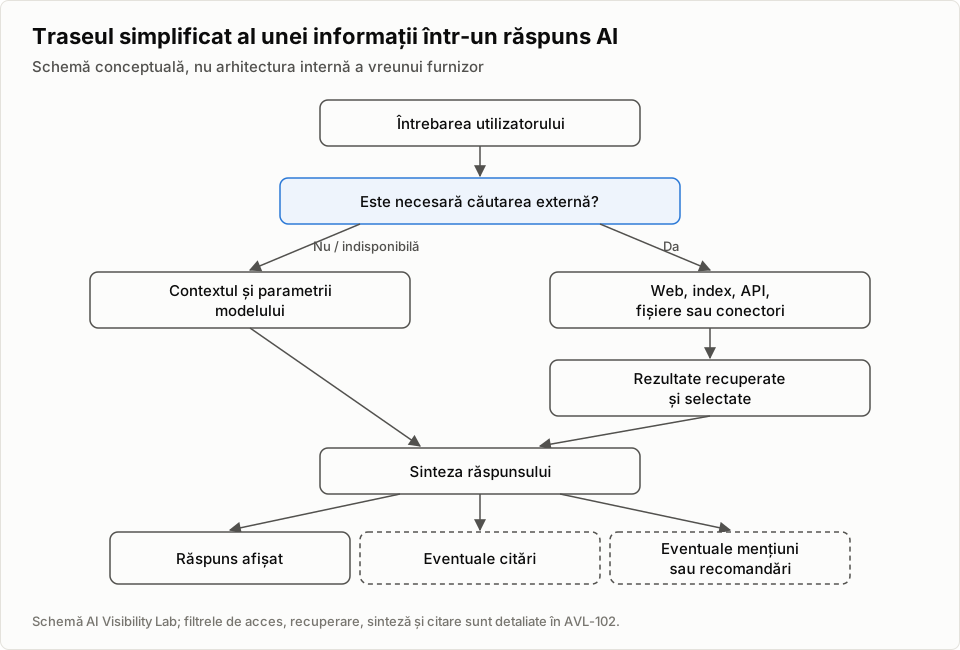
În documentul AI Visibility Lab „Cum aleg sistemele AI sursele și citările” (AVL-102), procesul este analizat prin patru filtre: acces, recuperare, sinteză și selecția citării. Aceste filtre sunt utile ca model de investigație, nu ca descriere exhaustivă, verificată, a codului intern al fiecărei platforme. 14
O sursă poate fi tehnic accesibilă, dar să nu fie recuperată pentru întrebarea respectivă. Poate fi recuperată, dar nefolosită. Poate contribui la un răspuns fără să apară în lista de citări. Iar o companie poate fi menționată chiar și atunci când propriul website nu este citat.
Ce știm din documentația oficială a produselor?
| Sistem sau produs | Mecanism public relevant | Limită de interpretare |
|---|---|---|
| ChatGPT / ChatGPT Search | OpenAI documentează căutarea web și separă în controlul crawlerelor OAI-SearchBot (căutare) de GPTBot (antrenare). 2 | Accesul crawlerului nu garantează includerea unui URL sau recomandarea unei entități. |
| Google AI Overviews / AI Mode | Google descrie posibilitatea unor căutări conexe de tip query fan-out; cele două produse pot folosi modele și tehnici diferite. 3 | O pagină eligibilă pentru Google Search nu este obligatoriu inclusă în răspunsul AI. |
| Perplexity | Documentația Pro Search descrie căutări multiple și sinteze cu linkuri către articole, studii, forumuri și alte tipuri de resurse. 4 | Numărul citărilor depinde de modul folosit și de întrebare. |
| Microsoft Copilot Chat | Microsoft precizează că poate transforma cererea într-o interogare trimisă către Bing, pentru a recupera informații de pe web. 5 | Experiențele Copilot diferă între produse și configurații, inclusiv cele pentru organizații. |
| Claude | Accesul la căutare și la alte instrumente depinde de mediul de utilizare și de configurație. | Nu putem descrie o listă fixă de surse valabilă pentru toate sesiunile Claude. |
Nu este vorba, așadar, doar despre „ce știe modelul”. Este vorba și despre ce poate accesa produsul prin care utilizatorul vorbește cu modelul.
3. Câte surse citează fiecare AI? Rezultatele unui experiment cu 960 de răspunsuri
Un studiu publicat de Prefer în septembrie 2026 a comparat 960 de răspunsuri: 80 de întrebări despre AI Search, GEO și AEO, adresate de trei ori fiecăruia dintre ChatGPT, Perplexity, Gemini și Claude. Măsurătorile au fost realizate la 13 septembrie 2026, prin API, solicitând căutare web la fiecare apel. 6
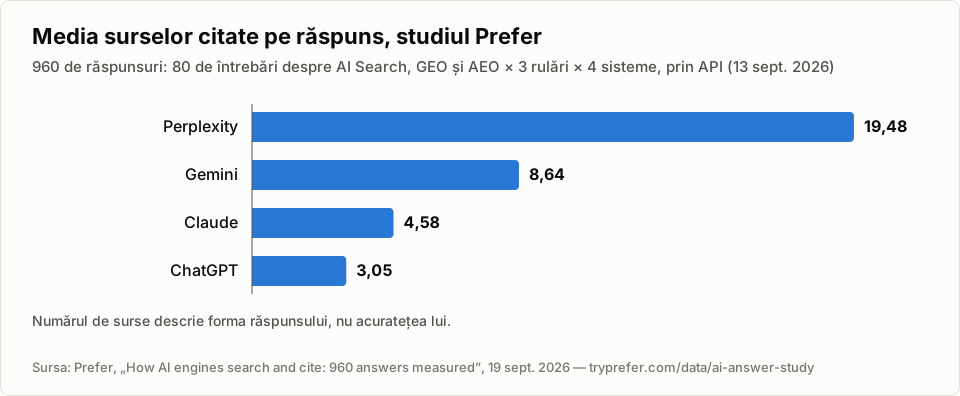
| Sistem AI | Răspunsuri testate | Medie surse citate / răspuns | Răspunsuri cu căutare web | Domenii distincte citate |
|---|---|---|---|---|
| Perplexity | 240 | 19,48 | 240 / 240 (100%) | 748 |
| Gemini | 240 | 8,64 | 213 / 240 (88,8%) | 580 |
| Claude | 240 | 4,58 | 192 / 240 (80,0%) | 333 |
| ChatGPT | 240 | 3,05 | 216 / 240 (90,0%) | 218 |
Interpretare. În acest set de întrebări, Perplexity a citat în medie de aproximativ 6,4 ori mai multe surse decât ChatGPT. Nu rezultă de aici că răspunsurile Perplexity au fost automat de 6,4 ori mai corecte, mai complete sau mai bune. Numărul de citări este un indicator al formei răspunsului și al surselor afișate, nu un test suficient de acuratețe.
Mai mult, studiul acoperă o tematică specializată. O distribuție similară nu este garantată pentru întrebări medicale, educaționale, locale, istorice sau strict comerciale. Utilizarea prin API, modelele configurate și momentul colectării sunt esențiale pentru reproductibilitate.
Dar ce se întâmplă când includem și Copilot?
Searlo a publicat un experiment separat, tot în septembrie 2026: 30 de întrebări — 22 despre produse și software („care este cel mai bun…”) și 8 de tip „cum fac…” —, formulate în engleză (setări pentru SUA) și adresate o singură dată fiecăruia dintre patru sisteme, prin API-ul propriu de colectare a răspunsurilor. 7
| Sistem AI | Mediana surselor / răspuns | Răspunsuri fără surse | Domenii distincte în întregul test |
|---|---|---|---|
| Perplexity | 10 | 0 din 30 | 216 |
| Microsoft Copilot | 10 | 0 din 30 | 233 |
| Gemini | 7 | 8 din 30 | 66 |
| ChatGPT | 5 | 6 din 30 | 77 |
Acest tabel nu poate fi combinat matematic cu cel anterior. Prefer raportează o medie a surselor citate; Searlo raportează mediana surselor pe răspuns. Studiile au întrebări, instrumente, metode și dimensiuni diferite. Tocmai de aceea este util să le privim ca două observații complementare, nu ca un singur clasament.
În testul Searlo, Perplexity a citat Reddit în 10 dintre cele 30 de răspunsuri, Gemini în patru, iar ChatGPT și Copilot în niciunul. Copilot a citat YouTube în șapte răspunsuri. Aceste frecvențe nu înseamnă că o platformă acceptă ori respinge prin definiție Reddit sau YouTube. Înseamnă numai că așa s-au distribuit citările în acel experiment. 7
4. De ce aceleași întrebări nu duc la aceleași surse?
Numărul linkurilor afișate este doar prima diferență. A doua privește identitatea domeniilor.
În studiul Prefer, cele 960 de răspunsuri au citat 1.329 de domenii distincte. Dintre acestea, 966 — adică 72,7% — au apărut în citările unui singur sistem. Numai 29 de domenii au fost citate de toate cele patru sisteme. 6
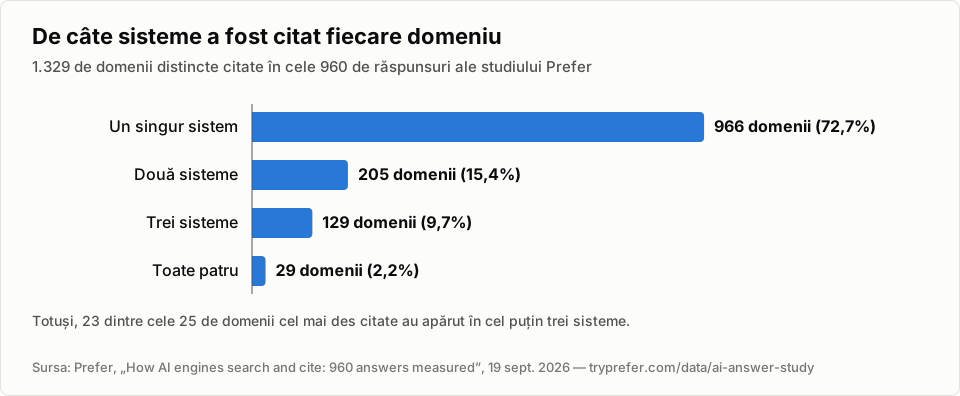
| Același domeniu a fost citat de… | Număr domenii | Pondere din total |
|---|---|---|
| Un singur sistem | 966 | 72,7% |
| Două sisteme | 205 | 15,4% |
| Trei sisteme | 129 | 9,7% |
| Toate patru sistemele | 29 | 2,2% |
Totuși, există o nuanță care schimbă interpretarea: 23 dintre cele 25 de domenii cel mai des citate au apărut în cel puțin trei sisteme. Sursele rare sunt puternic fragmentate, dar multe dintre sursele dominante traversează mai multe ecosisteme. Afirmația „fiecare AI folosește un internet complet diferit” ar fi, prin urmare, excesivă.
Și stabilitatea diferă. Conform indicatorului de suprapunere între rulările aceleiași întrebări definit de Prefer, rezultatul a fost de 96% pentru Perplexity, 68% pentru Claude, 37% pentru ChatGPT și 35% pentru Gemini. În acest experiment, anumite produse au repetat mai frecvent aceleași domenii, altele au variat mai mult. Aceste procentaje nu sunt cote de acuratețe și nu trebuie tratate drept proprietăți permanente ale sistemelor. 6
Diferența poate fi produsă de numeroși factori: indexurile disponibile, formularea căutărilor intermediare, selecția documentelor, configurarea modelelor, personalizare, localizare, starea webului și regulile produsului pentru afișarea citărilor. Din observațiile externe nu putem deduce, cu certitudine, contribuția fiecărei cauze în fiecare răspuns.
5. Sursa citată nu este același lucru cu brandul recomandat
Un studiu BrightEdge din august 2025 a comparat zeci de mii de interogări identice pe ChatGPT, Google AI Overviews și Google AI Mode. A identificat diferențe în seturile de branduri menționate pentru 61,9% dintre interogările analizate. Numai 17% au produs aceleași branduri în toate cele trei produse. 8
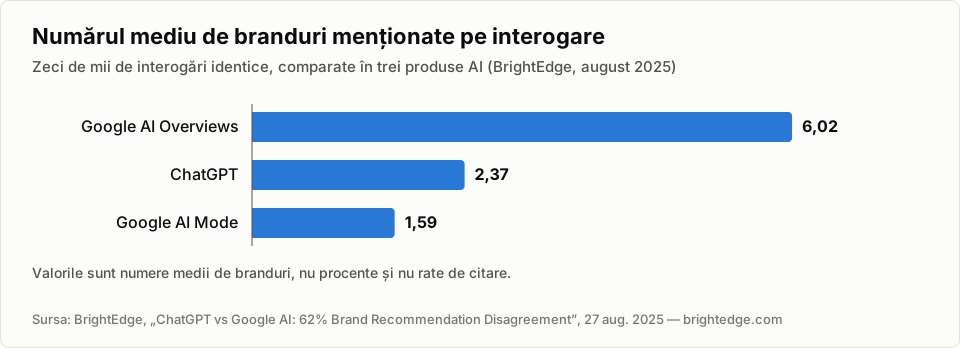
| Produs | Număr mediu de branduri menționate / interogare |
|---|---|
| Google AI Overviews | 6,02 |
| ChatGPT | 2,37 |
| Google AI Mode | 1,59 |
Aici este important un detaliu metodologic frecvent pierdut în preluările comerciale: 2,37 și 6,02 nu sunt procente, nu sunt „rate de citare” și nu exprimă probabilitatea ca o firmă să fie recomandată. Ele sunt numere medii de branduri menționate per interogare, în eșantionul BrightEdge. 8
Să luăm un exemplu ipotetic. Cineva întreabă: „Ce firmă oferă servicii de audit pentru vizibilitatea în AI?” Un sistem poate răspunde cu un paragraf explicativ și două surse, fără să recomande vreun furnizor. Alt sistem poate enumera cinci furnizori și poate cita doar directoare sau publicații terțe. Un al treilea poate menționa un brand fără să citeze site-ul acelui brand.
Din perspectiva unei firme, rezultatele nu sunt echivalente:
- Descoperire: informația despre companie este accesibilă și identificabilă.
- Mențiune: numele companiei apare efectiv în răspuns.
- Citare: propriul domeniu sau o sursă despre companie este afișată ca referință.
- Recomandare: compania este propusă ca opțiune pentru nevoia utilizatorului.
- Acțiune: utilizatorul intră pe site, solicită ofertă sau contactează firma.
Fiecare nivel poate fi observat și măsurat separat. Saltul de la unul la altul nu este garantat.
6. România: cât de mult folosesc oamenii AI și pentru ce?
Pentru România există două tipuri de dovezi care trebuie citite separat: statisticile oficiale despre adopția tehnologiei și sondajele care întreabă utilizatorii ce fac efectiv cu aceste instrumente.
Conform Eurostat, 17,8% dintre persoanele de 16–74 de ani din România au folosit instrumente de AI generativ în cele trei luni anterioare cercetării din 2025, față de 32,7% la nivelul Uniunii Europene. În grupa de vârstă 16–24 de ani, ponderea a fost de 44,1% în România, comparativ cu 63,8% în UE. 910
Într-un alt indicator Eurostat, 5,2% dintre întreprinderile românești cu cel puțin 10 angajați utilizau tehnologii AI în 2025, față de 20,0% în UE. Este un indicator despre întreprinderi și tehnologii AI, nu despre procentul tuturor firmelor care apar în răspunsurile ChatGPT. 11
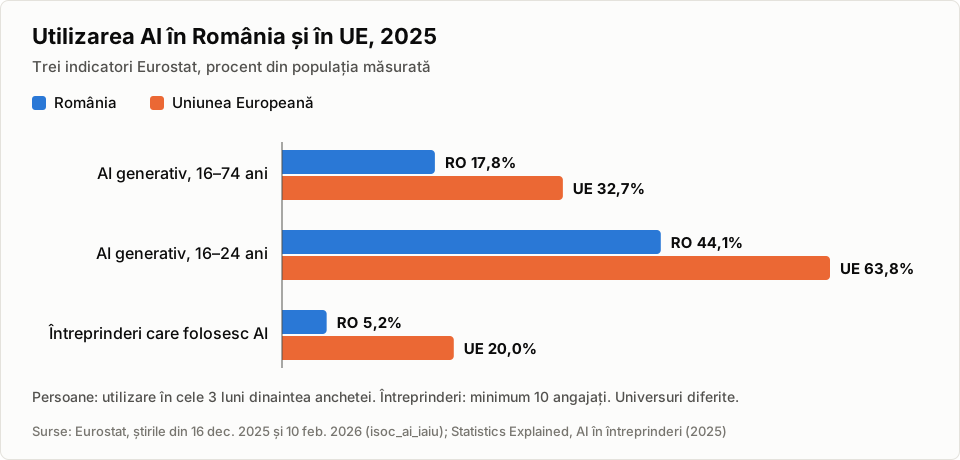
| Indicator Eurostat, 2025 | România | UE | Populația măsurată |
|---|---|---|---|
| Utilizare AI generativ | 17,8% | 32,7% | Persoane 16–74 ani, ultimele trei luni |
| Utilizare AI generativ în rândul tinerilor | 44,1% | 63,8% | Persoane 16–24 ani, ultimele trei luni |
| Utilizare tehnologii AI în întreprinderi | 5,2% | 20,0% | Întreprinderi cu minimum 10 angajați |
Datele nu justifică să spunem că „numai 17,8% dintre români folosesc vreodată AI” ori că „doar 5,2% dintre firme pot fi găsite de AI”. Sunt definiții statistice și universuri distincte. Pentru alți indicatori de adopție, măsurați diferit, vezi și „AI aleargă, adopția merge pe jos: decalajul din 2026”.
Când AI intră în decizia de cumpărare
Studiul Reveal Market Resources nr. 206, realizat online între 14 și 20 ianuarie 2026 pe 1.000 de adulți utilizatori de internet din mediul urban, raportează că 68% dintre respondenți folosesc AI în activitățile cotidiene, față de 47% în studiul anterior. În rândul utilizatorilor AI din eșantion, 91% declară că folosesc tehnologia pentru informații despre branduri și produse, iar 65% spun că le influențează decizia de cumpărare. 12
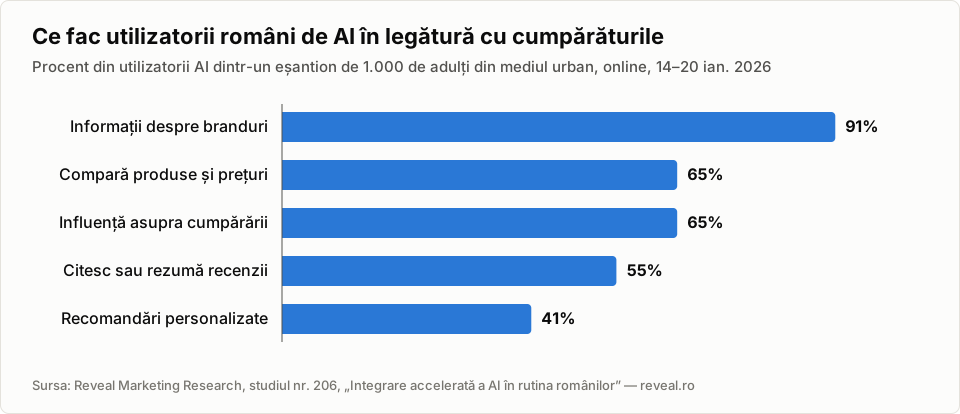
| Comportament declarat de utilizatorii AI | Procent raportat |
|---|---|
| Caută informații despre branduri și produse | 91% |
| Compară produse și prețuri | 65% |
| Declară influență asupra deciziei de cumpărare | 65% |
| Citesc sau rezumă recenzii cu AI | 55% |
| Obțin recomandări personalizate | 41% |
Același studiu a indicat ChatGPT drept platforma utilizată cel mai des dintre cele raportate: 83% dintre utilizatorii AI, urmat de Gemini (35%) și Microsoft Copilot (15%). Respondenții pot folosi mai multe platforme, astfel încât procentele nu se însumează la 100% și nu reprezintă cote de piață în sensul traficului sau veniturilor. 12
Diferența dintre Eurostat și Reveal nu este, în sine, o contradicție. Eurostat urmărește indicatori armonizați pentru populații și perioade definite; Reveal este un sondaj online în mediul urban, cu întrebări diferite și alte baze de calcul. Nu este corect să transformăm 17,8% și 68% într-o curbă a creșterii adopției AI, ca și cum ar reprezenta aceeași măsurătoare la un an distanță.
Ce putem spune, cu mai multă siguranță, este că în segmentul de utilizatori investigați de Reveal, AI participă deja la descoperirea produselor, comparație și documentarea deciziei de cumpărare.
7. Ce citează sistemele AI când răspund despre România?
Aici trecem de la intențiile declarate ale utilizatorilor la comportamentul observat al răspunsurilor.
7.1. Studiul MJRC: zece sisteme, două limbi și aproximativ 360.000 de răspunsuri
Proiectul AI Information Map: Romania, publicat de Media and Journalism Research Center (MJRC), analizează aproximativ 360.000 de răspunsuri arhivate, obținute de la zece sisteme AI cu întrebări despre România în română și engleză. Intervalul documentat este ianuarie 2025–martie 2026; cercetarea este prezentată ca fiind în desfășurare, iar anumite procente se pot actualiza. 13
În distribuția generală a surselor folosite sau citate, raportul evidențiază:
| Sursă | Pondere în sursele analizate de MJRC |
|---|---|
| Comisia Europeană | 4,0% |
| OECD | 3,9% |
| Romania Insider | 3,4% |
| Radio România Internațional | 3,2% |
| Wikipedia | 3,0% |
| Digi24 | 2,2% |
| Agerpres | 1,7% |
| YouTube | 1,6% |
| Reuters | 1,3% |
| HotNews | 1,2% |
| Libertatea | 1,1% |
| Știrile ProTV | 1,1% |
| Toate celelalte surse | 72,4% |
Procentele reprezintă ponderea surselor în corpusul MJRC, nu probabilitatea ca unul dintre aceste site-uri să fie citat la următoarea întrebare. Totalul poate diferi cu 0,1 puncte procentuale din cauza rotunjirilor.
Studiul semnalează și o diferență între limbile folosite: întrebările formulate în română au adus mai vizibil în răspuns publicații locale, în timp ce cele formulate în engleză au favorizat mai mult instituții și surse internaționale. Digi24 a avut, spre exemplu, o pondere de 4,1% între sursele aferente întrebărilor în română. 13
Interpretarea practică nu este „scrie totul exclusiv în română” sau „publică totul în engleză”. Mai util este să verificăm în ce limbă, cu ce formulare și pentru ce nevoie reală încearcă utilizatorii să identifice entitatea.
7.2. Monitorizarea GEOflux: diferențe între ChatGPT, Gemini și Perplexity
GEOflux publică un raport actualizat pe ferestre mobile de 30 de zile pentru România, bazat pe întrebări comerciale puse zilnic în cinci domenii — bănci, asigurări, modă, e-commerce și turism — sistemelor ChatGPT, Gemini și Perplexity. Raportul pentru bănci, de exemplu, folosește aceleași 25 de întrebări în fiecare zi. 1516
La consultarea raportului agregat din 7 noiembrie 2026, valorile afișate pentru numărul mediu de linkuri-sursă per răspuns erau următoarele:
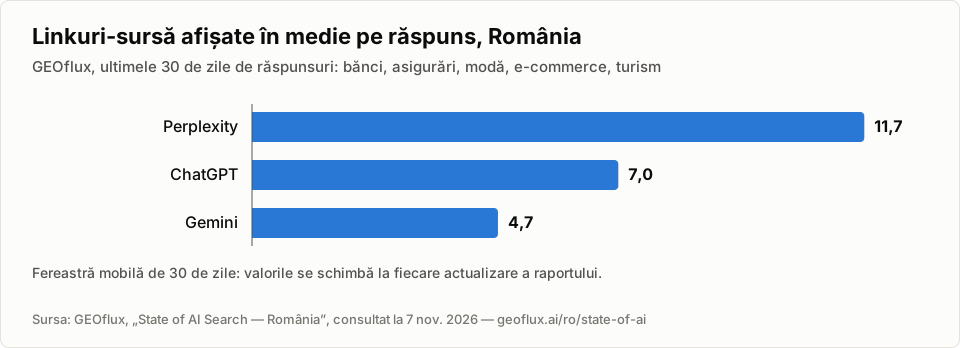
| Sistem | Linkuri-sursă medii / răspuns, în fereastra observată |
|---|---|
| Perplexity | 11,7 |
| ChatGPT | 7,0 |
| Gemini | 4,7 |
Aici avem o ilustrare foarte bună a caracterului contextual al statisticilor: rezultatele din România nu reproduc automat ordinea și proporțiile studiului Prefer. Raportul GEOflux este comercial, privește industrii definite și se actualizează; nu reprezintă un recensământ al tuturor răspunsurilor în limba română. Valorile afișate pot fi deja diferite când cititorul accesează pagina. 15
Monitorizarea arată și că sistemele pot plasa branduri diferite pe primul loc chiar în cadrul aceleiași industrii. În raportul pentru sectorul bancar din România, de exemplu, primul brand după frecvența mențiunilor diferă între ChatGPT, Gemini și Perplexity. Un clasament al vizibilității are sens numai împreună cu sistemul, industria, perioada și întrebările care l-au produs. 16
7.3. Piața de carte: a avea un site citat nu înseamnă a primi recomandarea
Websem a analizat 180 de răspunsuri în limba română despre cumpărarea de cărți, provenite din 18 întrebări, cinci sisteme și două rulări din iulie 2026. Cercetarea a monitorizat 21 de branduri și a identificat 422 de domenii distincte în răspunsurile care conțineau surse. 17
În 105 din cele 180 de răspunsuri (58%), niciunul dintre cele 21 de branduri mari monitorizate nu a fost menționat. Nu înseamnă că răspunsurile nu conțineau niciun brand posibil, ci că nu includeau branduri din grupul urmărit. Această delimitare este esențială.
Experimentul arată cât de greșită poate fi echivalența dintre notorietatea unui brand în piață și vizibilitatea sa într-un set de răspunsuri AI. În plus, un domeniu poate apărea ca sursă chiar dacă brandul asociat nu este recomandat explicit.
Raportul provine de la un furnizor comercial de servicii AEO/GEO și trebuie citit cu aceeași exigență metodologică pe care o aplicăm tuturor studiilor: interogări, perioadă, selecția brandurilor, mod de numărare și accesibilitatea datelor.
8. Ce ne spun toate acestea despre piața românească?
Cele trei tipuri de măsurători nu trebuie amestecate:
| Întrebarea cercetării | Exemplu de studiu | Ce putem concluziona | Ce nu putem concluziona |
|---|---|---|---|
| Cine folosește AI? | Eurostat, Reveal | Adopție și comportamente declarate în populațiile măsurate. | Ce branduri sunt citate în răspunsuri. |
| Ce surse sunt afișate? | Prefer, Searlo, MJRC, GEOflux | Domeniile și linkurile observate în răspunsuri concrete. | Compoziția integrală a datelor de antrenare. |
| Ce branduri sunt menționate? | BrightEdge, GEOflux, Websem | Frecvența mențiunilor în interogări definite. | Că mențiunea produce automat încredere, contact sau achiziție. |
| Cât de stabil este fenomenul? | Rulări repetate Prefer, GEOflux, Websem | Variație între sisteme și momente măsurate. | O regulă universală sau o garanție pe termen lung. |
Privite împreună, datele arată o piață în care utilizarea AI pentru informare și alegere comercială există deja, iar rezultatele afișate pot varia între platforme, limbi și nișe. Nu demonstrează însă că toate firmele trebuie să urmărească aceeași platformă, că numărul mai mare de citări este echivalent cu o recomandare mai bună sau că există o combinație de tactici care asigură includerea într-un răspuns.
În special pentru serviciile locale, rămâne o întrebare insuficient explorată: cum se comportă aceste sisteme atunci când un utilizator caută un prestator dintr-un oraș românesc, într-o categorie în care informația publică este incompletă, fragmentată sau contradictorie?
Această întrebare poate fi investigată prin aceleași principii pe care AI Visibility Lab le utilizează deja în Market Discovery: delimitarea universului de interogări, capturi și observații datate, diferențierea entităților, măsurare și interpretare. Datele despre adoptarea AI nu pot înlocui un astfel de experiment.
9. Cum ar trebui testată vizibilitatea unei entități?
Un audit punctual răspunde la întrebarea „ce s-a întâmplat în această sesiune?”. Pentru a evalua o tendință este nevoie de o metodă repetabilă.
Un protocol exploratoriu pentru România ar putea include:
- Un univers fix de întrebări, separat pe intenții: informare, comparație, recomandare, verificare, achiziție.
- Sisteme și configurații documentate: produsul folosit, modelul când este disponibil, țara, limba, tipul de cont, instrumentele și modul de căutare.
- Rulări repetate, în zile diferite, fără a interpreta diferența dintre două răspunsuri ca dovadă automată a unei modificări de algoritm.
- Capturi complete și datate: text, surse, URL-uri, entități, versiuni și erori observate.
- Codificare separată: apariția brandului, poziția mențiunii, mențiune neutră, recomandare, citarea propriului domeniu, citarea unei surse terțe.
- Clasificarea surselor: pagini oficiale, site-uri comerciale, directoare, publicații, comunități, documente instituționale și altele.
- Re-măsurare și comparabilitate: aceleași întrebări și reguli, cu schimbările de model și produs consemnate explicit.
Indicatorii utili nu se reduc la „câte linkuri am obținut?”. Pot fi calculați, între altele, ponderea răspunsurilor în care entitatea este menționată, frecvența recomandărilor, ponderea citărilor directe, diversitatea surselor, suprapunerea între platforme și variația rezultatelor între rulări.
În raportare trebuie păstrată distincția dintre observație, măsurare și interpretare. Dacă un brand apare în trei răspunsuri din zece, aceasta este o măsurare. Dacă presupunem că apariția este cauzată de un articol nou, aceea este o ipoteză care cere dovezi suplimentare.
10. Ce poate face o companie fără să controleze AI-ul?
Documentația publică nu oferă o formulă pentru obținerea garantată a unei citări. Ea oferă, totuși, indicii despre condițiile care merită verificate.
Mai întâi, identitatea. O companie trebuie să poată fi identificată fără ambiguitate: cine este, unde activează, ce oferă, cui se adresează și prin ce canale poate fi contactată. Numele inconsistent, lipsa datelor elementare și contradicțiile între website și profiluri fac verificarea dificilă atât pentru oameni, cât și pentru sisteme automate.
Apoi, accesibilitatea. Informația importantă trebuie să poată fi descoperită și interpretată tehnic: pagini accesibile, conținut relevant în HTML, structură clară, date actualizate și lipsa blocajelor accidentale. OpenAI documentează separarea controlului crawlerelor pentru căutare și antrenare; Google precizează că eligibilitatea în AI Overviews și AI Mode nu necesită „optimizări speciale” față de bunele practici fundamentale Search, dar nici nu garantează afișarea. 23
Urmează consistența și verificabilitatea. Un website propriu este o sursă primară controlabilă, dar informațiile externe pot contribui la descoperire, contextualizare și verificare: documentație publică, surse instituționale, publicații independente, directoare relevante, parteneriate și recenzii autentice. Nu toate sunt necesare pentru orice firmă. Nu toate sunt accesibile oricărui AI.
În sfârșit, măsurarea. Nu evaluăm o strategie pe baza unei singure capturi favorabile și nici nu alegem intervențiile doar pentru că un studiu a raportat multe citări de pe o anumită platformă. Comparăm comportamente repetate, căutăm explicații plauzibile și delimităm ce am observat de ce presupunem.
Această abordare nu promite vizibilitate. Ea creează condiții mai bune pentru ca o entitate să poată fi descoperită și înțeleasă atunci când un sistem AI ajunge la informațiile despre ea.
11. Limita fundamentală a studiilor: măsurăm sisteme care se schimbă în timp ce le studiem
Toate studiile prezentate aici sunt fotografii ale unor comportamente observate în intervale definite. Chiar și monitorizările care publică ferestre mobile de 30 de zile reprezintă măsurători aproape curente pentru un set limitat de interogări, nu o perspectivă completă, în timp real, asupra tuturor răspunsurilor generate de sistemele AI.
Între data colectării și data publicării unui studiu pot apărea modele noi, actualizări ale instrumentelor de căutare, modificări ale indexurilor, ajustări ale mecanismelor de selecție a surselor și schimbări ale interfețelor. La rândul lor, site-urile și informațiile publice se actualizează.
Să afirmăm că Perplexity a citat în medie 19,48 surse într-un experiment din septembrie 2026 este o afirmație verificabilă. Să spunem că „Perplexity citează întotdeauna aproximativ 19,5 surse” ar fi o generalizare nejustificată. Să observăm că un brand ocupă primul loc într-o fereastră de 30 de zile este util. Să promitem că îl va ocupa și luna următoare, pe baza acelei observații, ar depăși dovezile.
Aceste limitări nu invalidează studiile. Ele stabilesc domeniul în care concluziile lor sunt valabile. O cercetare bună nu devine inutilă atunci când sistemul studiat evoluează; devine un reper datat care poate fi comparat cu măsurători ulterioare.
Tocmai de aceea, o analiză AI Visibility matură are nevoie de dată, univers de întrebări, configurație, definițiile indicatorilor și arhivă de dovezi. Fără aceste elemente, o statistică poate fi reprodusă vizual foarte convingător și interpretată complet greșit.
Studiile ne spun ce s-a observat. Nu ne pot garanta ce va apărea la următoarea interogare.
Concluzie: să fim pregătiți să fim găsiți, nu să pretindem că vom fi aleși
Datele internaționale și cele despre România converg către o realitate: AI poate participa la modul în care oamenii află despre servicii, compară opțiuni și formulează decizii. Dar sistemele diferă prin sursele afișate, numărul citărilor, brandurile menționate și gradul de stabilitate de la o rulare la alta.
O companie nu controlează modelul, indexul, criteriile de sinteză și nici selecția citărilor. Nu poate obține o garanție că va fi menționată, citată sau recomandată prin simpla respectare a unei liste de „reguli GEO”.
Dar nici incertitudinea nu justifică pasivitatea.
Putem publica informații clare despre cine suntem și ce facem. Putem face aceste informații accesibile tehnic. Putem demonstra competență prin conținut și dovezi, construi relații cu surse independente, corecta inconsecvențele și observa periodic cum suntem reprezentați în răspunsurile AI.
Nu știm câtă greutate acordă fiecare sistem fiecăruia dintre acești factori în orice situație. Știm însă că o prezență publică incompletă, contradictorie sau inaccesibilă limitează inclusiv posibilitatea de a fi descoperit și verificat.
Obiectivul nu este să găsim formula prin care să obligăm AI-ul să ne recomande. Obiectivul este să facem tot ceea ce ține de noi pentru ca, atunci când un sistem AI ajunge să caute informații relevante despre domeniul, serviciile sau compania noastră, să aibă ce găsi, să înțeleagă ce găsește și să poată verifica informațiile.
Nu putem controla dacă vom fi aleși. Dar putem influența cât de pregătiți suntem să fim găsiți.
Întrebări frecvente
De unde își ia ChatGPT informațiile?
Din tipare învățate în etapa de antrenare și, când produsul și contextul permit, din informații recuperate prin instrumente precum căutarea web sau documente și conectori. Cele două mecanisme nu trebuie confundate. 12
Care AI citează cele mai multe surse?
În studiul Prefer din septembrie 2026, Perplexity a citat în medie 19,48 surse per răspuns, față de 8,64 Gemini, 4,58 Claude și 3,05 ChatGPT. Sunt rezultate ale acelui experiment, nu un clasament universal. 6
Dacă un website este accesibil crawlerelor AI, va fi citat?
Nu. Accesul este doar una dintre condițiile posibile ale descoperirii și utilizării informației. Citarea depinde și de interogare, de recuperare, de sinteză și de selecția surselor afișate. 2314
Este același lucru să fii citat și să fii recomandat?
Nu. Un răspuns poate cita un URL fără să recomande brandul asociat și poate menționa un brand fără să citeze website-ul propriu. 817
Ce procent dintre români folosesc AI?
Răspunsul depinde de populație și definiție. Eurostat raportează 17,8% pentru utilizarea AI generativ în ultimele trei luni de către persoanele de 16–74 de ani din România, în 2025. Sondajul Reveal din ianuarie 2026 raportează 68% utilizare a AI în activitățile cotidiene în eșantionul său de adulți utilizatori de internet din mediul urban. Indicatorii nu sunt direct comparabili. 912
Contează limba în care întreb un AI despre România?
Poate conta. Studiul MJRC a observat distribuții diferite ale surselor despre România în răspunsuri la întrebări formulate în română versus engleză. Aceasta este o observație a corpusului studiat, nu o regulă fără excepții. 13
Ce pot face dacă nu am garanția unei recomandări?
Să construiesc o identitate publică clară, surse accesibile și actualizate, informații verificabile și un proces de măsurare repetată. Aceste acțiuni nu garantează un rezultat, dar reduc problemele observabile pe care o companie le poate controla.
Note metodologice și limitări
- Tipul datelor: documentație oficială a furnizorilor, statistici publice, sondaje comerciale și cercetări externe asupra răspunsurilor AI. Nu sunt rezultate ale unui experiment nou realizat pentru acest articol.
- Grafice: cele șase grafice sunt redesenate de AI Visibility Lab din cifrele publicate de fiecare sursă, numită și legată sub fiecare grafic. Nu adaugă date proprii și nu recalculează indicatorii surselor.
- Perioadă: studiile citate acoperă ferestre distincte din 2025–2026. Ultima verificare a informațiilor folosite aici: 7 noiembrie 2026.
- Comparații: o medie a surselor, o mediană a surselor, o pondere a mențiunilor și o rată de utilizare a tehnologiei sunt indicatori diferiți. Nu se agregă într-un singur scor.
- Reprezentativitate: studiile internaționale au adesea întrebări în engleză ori domenii specializate; studiile românești au populații-țintă, industrii și proceduri proprii.
- Caracter dinamic: raportul GEOflux utilizează ferestre mobile; cifrele observate la redactare se pot modifica ulterior. Cercetarea MJRC menționează de asemenea actualizări periodice.
- Conflict de interese: BrightEdge, Prefer, Searlo, GEOflux și Websem operează în piețe conexe serviciilor SEO/AEO/GEO sau măsurării performanței. Studiile sunt folosite ca observații externe cu metodologie declarată, nu ca validare independentă a ofertelor lor comerciale. AI Visibility Lab cercetează aceeași piață.
- Calitatea citărilor: numărul de URL-uri nu este o măsură suficientă pentru acuratețe, originalitate, autoritate sau eficiență comercială.
Surse și metodologie
Documentație oficială
- OpenAI, How ChatGPT and our foundation models are developed — categorii de date, pre-training, post-training, date sintetice.
- OpenAI, Overview of OpenAI Crawlers — OAI-SearchBot, GPTBot, separarea rolurilor și controlul accesului.
- Google Search Central, AI features and your website — AI Overviews, AI Mode, query fan-out, eligibilitate și limite.
- Perplexity Help Center, What is Pro Search? — procesul public de căutare și afișare a surselor.
- Microsoft Support, How web search works in Copilot Chat and agents — folosirea căutării Bing.
Studii de comportament al sistemelor AI
- Prefer, How AI engines search and cite: 960 answers measured, publicat la 19 septembrie 2026; colectare la 13 septembrie 2026.
- Searlo, ChatGPT, Perplexity, Copilot and Gemini Cite Different Sources: A 120-Answer Study, 29 septembrie 2026; actualizat la 5 octombrie 2026.
- BrightEdge, ChatGPT vs Google AI: 62% Brand Recommendation Disagreement, 27 august 2025.
România: adopție, utilizare și surse citate
- Eurostat, 32.7% of EU people used generative AI tools in 2025, 16 decembrie 2025.
- Eurostat, 64% of 16–24-year-olds used AI in 2025, 10 februarie 2026.
- Eurostat, Use of artificial intelligence in enterprises — Statistics Explained — date 2025.
- Reveal Marketing Research, Integrare accelerată a AI în rutina românilor, studiul nr. 206, 14–20 ianuarie 2026.
- Media and Journalism Research Center, AI Information Map: Romania — 10 sisteme, 2 limbi, cercetare 2025–2026.
- AI Visibility Lab, AVL-102 — Cum aleg sistemele AI sursele și citările — modelul celor patru filtre.
- GEOflux, State of AI Search — România — monitorizare comercială, fereastră mobilă, consultare 7 noiembrie 2026.
- GEOflux, Bănci în România: Stadiul căutării AI — monitorizare sectorială a mențiunilor și citărilor.
- Websem, Cine vinde cărți când clientul întreabă un AI?, experiment iulie 2026.
Lecturi conexe din AI Visibility Lab
- Public nu mai înseamnă accesibil: de ce fiecare sistem AI vede un internet diferit
- Harta de citare: cum afli empiric ce surse contează pentru vizibilitatea AI în România
- Social media devine strat informațional pentru AI
- Market Discovery — AI Visibility Lab
Notă de volatilitate
Documentația furnizorilor, comportamentul produselor AI și rapoartele pe ferestre mobile (GEOflux, MJRC) se pot schimba după data verificării. Valorile GEOflux din Graficul 6 sunt cele afișate la 7 noiembrie 2026. Toate sursele au fost verificate la 7 noiembrie 2026.
Articol publicat de AI Visibility Lab, proiect independent de cercetare aplicată și documentare în AI Visibility, GEO și AEO, fondat și coordonat de Alex Matescu. Ultima verificare factuală și a surselor: 7 noiembrie 2026.